Python库
程序易错点 :
- 变量未声明
- i,j,k变量写错了
- 变量名一定要看清楚
- 函数体内变量和外部变量分不清,变量名相近的一定要看清楚
七夕祭
题目大意: TYVJ 七夕祭的会场是一个 N 行 M 列的矩形,共有 N×M 个摊点。Vani 邀请 cl 同学来参加,但 cl 只对其中的一部分摊点感兴趣。Vani 希望能够通过调整摊点的布置,使得每行和每列中 cl 感兴趣的摊点数相等。现在需要判断是否能满足这两个要求,并计算最少需要交换的摊点数。
实现思路:
- 定义函数
get(a, n),用于计算数组a中使得每个元素都等于其中位数所需的最少操作次数。该函数首先计算数组a的均值,然后计算数组中每个元素与均值的差值,取差值的中位数作为目标中位数。接着计算每个元素与目标中位数的差值的绝对值之和,即为最少操作次数。 - 解析输入,统计每行和每列中 cl 感兴趣的摊点数,并保存在数组
r和c中。 - 根据 cl 感兴趣的摊点数是否能被行数和列数整除,分情况讨论:
- 如果不能同时整除行数和列数,则输出 “impossible”。
- 如果能同时整除行数和列数,即
t % n == 0且t % m == 0,则说明可以通过调整摊点使得每行和每列中 cl 感兴趣的摊点数相等。输出 “both”,并调用get函数计算最少交换次数。 - 如果只能整除行数或者列数,而不能同时整除,则说明只能使每行或者每列中 cl 感兴趣的摊点数相等。分别输出 “row” 或者 “column”,并调用
get函数计算最少交换次数。
$p[i] : i给i+1 \enspace p[i]个糖果$ $则 ans = \sum_{i=1}^n|p[i]| $ $ p[1]=a[1]-avg $ $递推 \enspace p[2]=p[1]+a[2]-avg $ $p[3]=p[2]+a[3]-avg = p[1]+a[2]-avg+a[3]-avg $ $p[4]=p[3]+a[4]-avg = p[2]+p[3]-avg+a[4]-avg = p[1]+a[2]-avg+a[3]-avg+a[4]-avg $ $=\sum_{i=2}^4{(a[i]-avg)} - p[1] $
from collections import defaultdict

r = defaultdict(int)
c = defaultdict(int)
s = defaultdict(int)

def get_ans(a, n):
    ans = 0
    avg = sum(a.values()) // n
    for i in a:
        a[i] -= avg
    s[1] = 0
    prev_sum = 0
    sorted_values = sorted(a.values())
    mid = sorted_values[n // 2]
    for i in range(2, n + 1):
        prev_sum += a[i]
        s[i] = prev_sum
    for i in s.values():
        ans += abs(i - mid)
    return ans

n, m, t = map(int, input().split())
for _ in range(t):
    x, y = map(int, input().split())
    r[x] += 1
    c[y] += 1

if t % n != 0 and t % m != 0:
    print("impossible")
elif t % n == 0 and t % m == 0:
    print("both", get_ans(r, n) + get_ans(c, m))
elif t % n == 0:
    print("row", get_ans(r, n))
else:
    print("column", get_ans(c, m))
线段树
#include <iostream>
#include <vector>
#include <cmath>
using namespace std;

const int mod = 998244353;

vector<int> tr;

void pushup(int u) {
    tr[u] = (1LL * tr[u<<1] * tr[u<<1|1]) % mod;
}

void build(int u, int l, int r, vector<int>& a) {
    if (l == r) {
        tr[u] = a[l];
        return;
    }

    int mid = (l + r) >> 1;
    build(u<<1, l, mid, a);
    build(u<<1|1, mid+1, r, a);
    pushup(u);
}

void modify(int u, int l, int r, int x, int v) {
    if (l == r) {
        tr[u] = v;
        return;
    }

    int mid = (l + r) >> 1;
    if (x <= mid) {
        modify(u<<1, l, mid, x, v);
    } else {
        modify(u<<1|1, mid+1, r, x, v);
    }

    pushup(u);
}

int query(int u, int l, int r, int ql, int qr) {
    if (ql <= l && r <= qr) {
        return tr[u];
    }

    int mid = (l + r) >> 1;
    int res = 1;
    if (ql <= mid) {
        res = 1LL * res * query(u<<1, l, mid, ql, qr) % mod;
    }
    if (qr > mid) {
        res = 1LL * res * query(u<<1|1, mid+1, r, ql, qr) % mod;
    }

    return res;
}

int main() {
	ios::sync_with_stdio(false); cin.tie(0); cout.tie(0);
    int n, m;
    cin >> n >> m;

    tr.resize(1 << (int)ceil(log2(n)) + 1);

    vector<int> a(n + 1);
    for (int i = 1; i <= n; ++i) {
        cin >> a[i];
    }

    build(1, 1, n, a);

    for (int i = 0; i < m; ++i) {
        int op;
        cin >> op;
        if (op == 1) {
            int l, r, x;
            cin >> l >> r >> x;
            for (int pos = l; pos <= r; ++pos) {
                if (a[pos] <= x) {
                    modify(1, 1, n, pos, x);
                    a[pos] = x;
                }
            }
        } else {
            int l, r;
            cin >> l >> r;
            cout << query(1, 1, n, l, r) << endl;
        }
    }

    return 0;
}
from sys import stdin
input = lambda:stdin.readline().strip()

def pushup(u):
    tr[u] = tr[u<<1] * tr[u<<1|1] % mod

def build(u, l, r):
    if l==r:
        tr[u] = a[l]
        return

    mid = l+r>>1
    build(u<<1, l, mid)
    build(u<<1|1, mid+1, r)
    pushup(u)

def modify(u, l, r, x, v):
    if l==r:
        tr[u] = v
        return

    mid = l+r>>1
    if x<=mid:
        modify(u<<1, l, mid, x, v)
    else:
        modify(u<<1|1, mid+1, r, x, v)

    pushup(u)

def query(u, l, r, ql, qr):
    if ql<=l and r<=qr:
        return tr[u]%mod

    mid = l+r>>1
    res = 1
    if ql<=mid:
        res = res*query(u<<1, l, mid, ql, qr)%mod
    if qr>mid:
        res = res*query(u<<1|1, mid+1, r, ql, qr)%mod

    return res

n, m = map(int, input().split())
tr = [1]*(1<<n.bit_length() + 1)

a = [0] + list(map(int, input().split()))
mod = 998244353

build(1, 1, n)

for i in range(m):
    q = list(map(int, input().split()))
    if q[0]==1:
        _, l, r, x = q
        for pos in range(l, r+1):
            if a[i]<=x:
                modify(1, 1, n, pos, x)
                a[i] = x
    else:
        _, l, r = q
        print(query(1, 1, n, l, r))
题目
日期差值
mm = [0, 31, 28, 31, 30, 31, 30, 31, 31, 30,31, 30, 31]

def day(x):
    y = int(x/10000)
    m = int((x/100)%100)
    d = x%100
    mm[2]=29 if (y%4==0 and y%100!=0) or y%400==0 else 28
    for i in range(1, m):
        d+=mm[i]
    for i in range(1, y):
        d+=366 if (i%4==0 and i%100!=0) or i%400==0 else 365
    return d

while True:
    try:
        x=int(input())
        y=int(input())
        print( abs(day(x)-day(y))+1 )
    except:
        break
特殊排序
# Forward declaration of compare API.
# def compare(a, b):
# @param a, b int
# @return bool
# return bool means whether a is less than b.

class Solution(object):
    def specialSort(self, N):
        """
        :type N: int
        :rtype: List[int]
        """
        a = [1]
        for i in range(2, N+1):
            l, r = 0, len(a)-1
            while l<r:
                mid = (l+r)>>1
                if compare(i, a[mid]):
                    r=mid
                else:
                    l=mid+1
            a[r+1:]=a[r:]
            a[r]=i
            if compare(a[r+1],a[r]):
                a[r], a[r+1] = a[r+1], a[r]
        return a
线段树
# 定义树节点,l,r, val表示该节点记录的是区间[l, r]的最大值是val
class Tree():
    def __init__(self):
        self.l = 0
        self.r = 0
        self.lazy = 0
        self.val = 0

# 二叉树是堆形式,可以用一维数组存储,注意数组长度要开4倍空间
tree = [Tree() for i in range(10*4)]

# 建树,用cur<<1访问左子树,cur<<1|1访问右子树,位运算操作很方便
def build(cur, l, r):
    tree[cur].l, tree[cur].r, tree[cur].lazy, tree[cur].val = l, r, 0, 0
    # 当l==r的时候结束递归
    if l < r:
        mid = l + r >> 1
        build(cur<<1, l, mid)
        build(cur<<1|1, mid+1, r)

# 当子节点计算完成后,用子节点的值来更新自己的值
def pushup(cur):
    tree[cur].val = max(tree[cur<<1].val, tree[cur<<1|1].val)

# 单点更新
def add(cur, x, v):
    if tree[cur].l == tree[cur].r:
        tree[cur].val += v
    else:
        mid = tree[cur].r + tree[cur].l >> 1
        if x > mid:
            add(cur>>1|1, x, v)
        else:
            add(cur<<1, x, v)
        pushup(cur)

# 将lazy标记向下传递一层
def pushdown(cur):
    if tree[cur].lazy:
        lazy = tree[cur].lazy
        tree[cur<<1].lazy += lazy
        tree[cur<<1|1].lazy += lazy
        tree[cur<<1].val += lazy
        tree[cur<<1|1].val += lazy
        tree[cur].lazy = 0

# 区间更新
def update(cur, l, r, v):
    if l <= tree[cur].l and tree[cur].r <= r:
        tree[cur].lazy += v
        tree[cur].val += v
        return
    if r < tree[cur].l or l > tree[cur].r:
        return
    if tree[cur].lazy:
        pushdown(cur)
    update(cur<<1, l, r, v)
    update(cur<<1|1, l, r, v)
    pushup(cur)

# 区间查询
def query(cur, l, r):
    if l <= tree[cur].l and tree[cur].r <= r:
        return tree[cur].val
    if tree[cur].l > r or tree[cur].r < l:
        return 0
    if tree[cur].lazy:
        pushdown(cur)
    return max(query(cur<<1, l, r), query(cur<<1|1))

# 测试
# -----
#        ---
#  -------
#   --
#         --

build(1, 1, 10)
update(1, 1, 5, 1)
update(1, 7, 10, 1)
update(1, 2, 8, 1)
update(1, 3, 4, 1)
update(1, 9, 10, 1)
print(query(1, 1, 10))
def pushup(u):
    tr[u] = tr[u << 1] + tr[u << 1 | 1]

def build(u, l, r):
    if l == r:
        tr[u] = 0
    else:
        mid = (l + r) >> 1
        build(u << 1, l, mid)
        build(u << 1 | 1, mid + 1, r)
        pushup(u)

def query(u, l, r, ql, qr):
    if l >= ql and r <= qr:
        return tr[u]
    mid = (l + r) >> 1

    if mid==l and mid==r:
        return 0

    res = 0
    if ql <= mid:
        res = query(u << 1, l, mid, ql, qr)
    if qr > mid:
        res += query(u << 1 | 1, mid + 1, r, ql, qr)
    return res

def modify(u, x, l, r, val):
    if l == r:
        tr[u] += val
    else:
        mid = (l + r) >> 1
        if x <= mid:
            modify(u << 1, x, l, mid, val)
        else:
            modify(u << 1 | 1, x, mid + 1, r, val)
        pushup(u)
Python特点
IDLE 使用
设置字体,行号,和使用docs
快捷键:
| 快捷键 | 功能 | 可用窗口 |
|---|---|---|
| F1 | 打开 Python 帮助文档 | Python 文件窗口和 Shell |
| Alt+P | 浏览历史命令(上一条) | 仅 Python Shell 窗口 |
| Alt+N | 浏览历史命令(下一条) | 仅 Python Shell 窗口 |
| Alt+/ | 自动补全前面曾经出现过的单词,如果之前有多个单词具有相同前缀,可以连续按下该快捷键,在多个单词中间循环选择 | Python 文件窗口和 Shell |
| Alt+3 | 注释代码块 | 仅 Python 文件窗口 |
| Alt+4 | 取消代码块注释 | 仅 Python 文件窗口 |
| Alt+g | 转到某一行 | 仅 Python 文件窗口 |
| Ctrl+Z | 撤销一步操作 | Python 文件窗口和 Shell |
| Ctrl+Shift+Z | 恢复上—次的撤销操作 | Python 文件窗口和 Shell |
| Ctrl+S | 保存文件 | Python 文件窗口和 Shell |
| Ctrl+] | 缩进代码块 | 仅 Python 文件窗口 |
| Ctrl+[ | 取消代码块缩进 | 仅 Python 文件窗口 |
| Ctrl+F6 | 重新启动 Python Shell | 仅 Python Shell 窗口 |
输入输出
输出列表:
print(*a) # 输出列表中的所有数,用空格分隔
print(*a, sep="\n") #每个数单独放一行
*运算符
解包运算符: 当
*运算符用于可迭代对象(如列表、元组、集合等)前面时,它可以将可迭代对象解包为多个元素。例如:a = [1, 2, 3] print(*a) # 解包并打印出每个元素:1 2 3可变参数: 当
*运算符用于函数定义时,它表示接受任意数量的参数,并将它们作为元组传递给函数。这种用法通常称为可变参数。例如:def my_func(*args): for arg in args: print(arg) my_func(1, 2, 3) # 打印出每个参数:1 2 3扩展运算符: 当
*运算符用于可迭代对象前面时,它可以将可迭代对象的元素扩展到另一个可迭代对象中。这种用法通常称为扩展运算符。例如:a = [1, 2, 3] b = [4, 5, 6 c = [*a, *b] # 扩展a和b的元素到c中 print(c) # 输出:[1, 2, 3, 4, 5, 6]乘法运算符: 当
*运算符用于数字和可迭代对象之间时,它表示重复该可迭代对象的元素。例如:a = [1, 2, 3] b = a * 3 # 重复a的元素3次 print(b) # 输出:[1, 2, 3, 1, 2, 3, 1, 2, 3]
*和**
*和**在函数定义中的使用:*args用于接收任意数量的位置参数,并将它们作为元组传递给函数。**kwargs用于接收任意数量的关键字参数,并将它们作为字典传递给函数。
*和**在函数调用中的使用:- 在函数调用时,
*用于解包可迭代对象,并将其作为位置参数传递给函数。 - 在函数调用时,
**用于解包字典,并将其作为关键字参数传递给函数。
- 在函数调用时,
栈模拟递归
from collections import deque
def dfs(idx,p):
    q = deque()
    q.append((idx,p))
    while q:
        idx,p = q.pop()
        D[idx] = D[p] + V[idx]
        for u in A[idx]:
            if u == p: continue
            q.append((u,idx))
引用赋值、浅拷贝和深拷贝
Python赋值、浅拷贝、深拷贝的区别
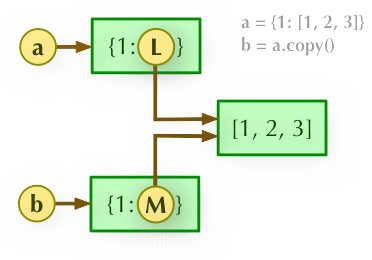
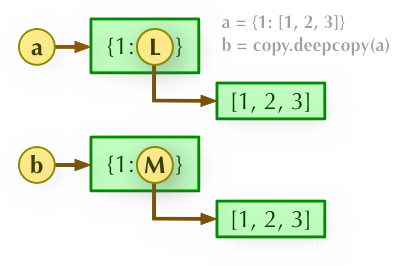
[:]和.copy()都属于“浅拷贝”,只拷贝最外层元素,外层元素是独立内存;内层嵌套元素则通过引用方式共享,而非独立分配内存。使用 copy 模块的 copy.copy( 浅拷贝 )和 copy.deepcopy(深拷贝),其中deepcopy是构建了一个完全独立的对象。
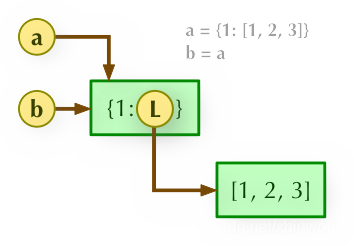
1、b = a: 赋值引用,a 和 b 都指向同一个对象。
2、b = a.copy(): 浅拷贝, a 和 b 是一个独立的对象,但他们的子对象(内层嵌套对象)还是指向统一对象(是引用)。
3、b = copy.deepcopy(a): 深度拷贝, a 和 b 完全拷贝了父对象及其子对象,两者是完全独立的。
例子:
引用赋值
>>>a = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
>>>b = a[:]
>>>print(b)
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
>>>print(id(a)) #41946376
>>>print(id(b)) #41921864
或
>>>b = a.copy()
>>>print(b)
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
>>>print(id(a)) #39783752
>>>print(id(b)) #39759176
浅拷贝
>>>a = [1,2,['A','B']]
>>>print('a={}'.format(a))
>>>b = a[:]
>>>b[0] = 9 #修改b的最外层元素,将1变成9
>>>b[2][0] = 'D' #修改b的内嵌层元素
>>>print('a={}'.format(a))
>>>print('b={}'.format(b))
>>>print('id(a)={}'.format(id(a)))
>>>print('id(b)={}'.format(id(b)))
a=[1, 2, ['A', 'B']] #原始a
a=[1, 2, ['D', 'B']] #b修改内部元素A为D后,a中的A也变成了D,说明共享内部嵌套元素,但外部元素1没变。
b=[9, 2, ['D', 'B']] #修改后的b
id(a)=38669128
id(b)=38669192
深拷贝
import copy
a = [1, 2, 3, 4, ['a', 'b']] #原始对象

b = a                       #赋值,传对象的引用
c = copy.copy(a)            #对象拷贝,浅拷贝
d = copy.deepcopy(a)        #对象拷贝,深拷贝

a.append(5)                 #修改对象a
a[4].append('c')            #修改对象a中的['a', 'b']数组对象

print( 'a = ', a )
print( 'b = ', b )
print( 'c = ', c )
print( 'd = ', d )

#输出:
'a = ', [1, 2, 3, 4, ['a', 'b', 'c'], 5]
'b = ', [1, 2, 3, 4, ['a', 'b', 'c'], 5]
'c = ', [1, 2, 3, 4, ['a', 'b', 'c']]
'd = ', [1, 2, 3, 4, ['a', 'b']]
栈代替递归
增加递归深度
import sys
sys.setrecursionlimit(150000000)
print(sys.getrecursionlimit())
迭代加深搜索
s = input()
l = len(s)
s = "0" + s  # 1~l
ans = set()
st = {}

def dfs(curlen, last):
    global ans, st
    stack = [(curlen, last)]
    while stack:
        curlen, last = stack.pop()
        if curlen - 2 > 4 and last != s[curlen - 1:curlen + 1]:
            if (curlen - 1, curlen) not in st:
                st[(curlen - 1, curlen)] = 1
                ans.add(s[curlen - 1:curlen + 1])
                stack.append((curlen - 2, s[curlen - 1:curlen + 1]))

        if curlen - 3 > 4 and last != s[curlen - 2:curlen + 1]:
            if (curlen - 2, curlen) not in st:
                st[(curlen - 2, curlen)] = 1
                ans.add(s[curlen - 2:curlen + 1])
                stack.append((curlen - 3, s[curlen - 2:curlen + 1]))

dfs(l, "")
ans = sorted(ans)  # 将集合转换为列表并排序
print(len(ans))
for si in ans:
    print(si)
加速读入
import sys
input = lambda:sys.stdin.readline().strip()

a = int(input())
print(a)
队列
Queue中有FIFO(先入先出)队列Queue,LIFO(后入先出)栈LifoQueue,和优先级队列PriorityQueue,但速度较慢,且不能不出栈地访问头部元素,想要访问头部元素,只能用get方法出栈首部获取方法返回值的来进行访问,非常不方便。
可以用deque()模拟
import collections

q=collections.deque()

m=int(input())
for i in range(m):
    s = input().split()
    if s[0]=='push':
        q.append(s[1])
    elif s[0]=='pop':
        q.popleft()
    elif s[0]=='empty':
        if len(q)==0:
            print('YES')
        else:
            print('NO')
    else:
        print(q[0])
栈
列表模拟
m=int(input())

stk=[]
for i in range(m):
    s = input().split()
    if s[0]=='push':
        stk.append(int(s[1]))
    elif s[0]=='pop':
        stk.pop()
    elif s[0]=='empty':
        if len(stk)==0:
            print('YES')
        else:
            print('NO')
    else:
        print(stk[-1])
deque模拟
import collections

stk = collections.deque()

m=int(input())
for i in range(m):
    s = input().split()
    if s[0]=='push':
        stk.appendleft( int(s[1]) )
    elif s[0]=='pop':
        stk.popleft()
    elif s[0]=='empty':
        if len(stk)==0:
            print('YES')
        else:
            print('NO')
    else:
        print(stk[0])
Python 常用内置库
array | 定长数组 |
|---|---|
argparse | 命令行参数处理 |
bisect | 二分查找 |
collections | 有序字典、双端队列等数据结构 |
fractions | 有理数 |
heapq | 基于堆的优先级队列 |
io | 文件流、内存流 |
itertools | 迭代器 |
math | 数学函数 |
os.path | 系统路径等 |
random | 随机数 |
re | 正则表达式 |
struct | 转换结构体和二进制数据 |
sys | 系统信息 |
defaultdict()
from collections import defaultdict
# 创建一个 defaultdict,指定默认值为 int 类型的 0
d = defaultdict()
# 修改默认值为 100
d.default_factory = lambda: 100
g = defaultdict(lambda:defaultdict(lambda:INF)) #同样的效果 邻接矩阵
Counter()
from collections import Counter

# 定义一个列表
lst = [1, 2, 2, 3, 3, 3, 4, 4, 4, 4]
s = 'abcdgsaa'

# 使用 Counter 统计列表中元素的出现次数
c1 = Counter(lst)
c2 = Counter(s)

print(c1,c2, sep='\n')

# 使用 most_common() 方法按照元素的出现次数进行排序
sorted_items = c1.most_common()

for x,y in enumerate(sorted_items):
    print(y[0])
c.elements()
c.update(b) #将两个Counter合并, 对应元素数目相加
c.subtract(b) # 对应元素数目相减
heapq
建堆 ( 小根堆 )
a = [1, 5, 20, 18, 10, 200]
heapq.heapify(a)
print(a)
建大根堆
a = []
for i in [1, 5, 20, 18, 10, 200]:
    heapq.heappush(a,-i)
print( list( map(lambda x:-x,a) ) )
heap_sort(heappush)
import heapq
def heap_sort(arr):
    if not arr:
        return []
    h = []  #建立空堆
    for i in arr:
        heapq.heappush(h,i) #heappush自动建立小根堆
    return [heapq.heappop(h) for i in range(len(h))]  #heappop每次删除并返回列表中最小的值
# 堆排序取最小的m个数字
import heapq
def heap_sort(arr, k):
    if not arr:
        return []
    h=[]
    for i in arr:
        heapq.heappush(h, i)
    return [heapq.heappop(h) for _ in range(k)]

n,m = map(int, input().split())
arr = list(map(int, input().split()))
ans = heap_sort(arr, m)
print(' '.join(map(str, ans)))
heappushpop
pop弹出堆顶元素
先push再pop
[1, 18, 5, 20, 90, 10, 200]
h
[1, 18, 5, 20, 90, 10, 200]
heapq.heappushpop(h, 300)
1
h
[5, 18, 10, 20, 90, 300, 200]
heapreplace
先pop再push
h
[5, 18, 10, 20, 90, 300, 200]
heapq.heapreplace(h, -1)
5
h
[-1, 18, 10, 20, 90, 300, 200]
heapq.merge
import heapq
h1 = [90, 1, 5, 20, 18, 10, 200]
h2 = [4,2,3,4,1000]
heapq.heapify(h1)
heapq.heapify(h2)
print(list(heapq.merge(h1, h2)))
heap.nlargest
h1
[1, 18, 5, 20, 90, 10, 200]
heapq.nlargest(2,h1,key=lambda x:-x)
heapq.nsmallest()
[1, 5]
list()
del list[1] 删除列表元素

列表比较
	import operator
    operator.eq(a,b)
len(list)
max(list)
min(list)
list(seq) 将元组转换为列表

list.append(obj)
list.count(obj)
list.extend(seq)
list.index(obj)
list.insert(index, obj)
list.pop([index=-1]) 删除列表中一个元素
list.remove(obj) 删除第一个匹配项
list.reverse()
list.sort(key=None, reverse=False)
list.clear()
list.copy()
tuple() 元素组合
类似list
SortedList()
from sortedcontainers import SortedList
sl = SortedList()
sl.add(1)
print(sl[-1])
print(sl[0])
sl.update([3,2,1])
print(sl)
sl.update([9,8,7])
print(sl)
##sl.clear()
sl.discard(5)
sl.remove(9)
print(sl)
sl.pop()
print(sl)
sl.pop(-2)
print(sl)
print(sl.bisect_left(12)) #返回需要插入的位置,如有存在则返回左侧的位置
print(sl.bisect_right(2))
print(sl.count(1))
print(sl.index(1))
it = sl.islice(2,4)
print(list(it))
dict()
键值必须不可变
d = {'1':'a', '2':'b', '99':'xycz'}
print(d)
if '0' in d :del d['0']
del d['1']
print(d)

{'1': 'a', '2': 'b', '99': 'xycz'}
{'2': 'b', '99': 'xycz'}
内置方法
len str type
dict.clear()
dict.copy()
dict.fromkeys(seq) 将seq作为字典的键值, 字典中val为默认
dict.get(key, default=None) # 不需要写default
key in dict
dict.items()
dict.keys()
dict.setdefault(key, default = None)
# 用于在字典中查找指定键(key)。如果键存在,则返回对应的值;如果键不存在,则在字典中设置该键,并将默认值(default)作为其值,并返回该默认值。
dict.update(dict2) #把dict2添加到dict中
dict.values() #返回值
pop(key[,default]) #删除字典中key所对应的值并返回
popitem() #返回并删除字典中最后一对键值
set()
空集合用set()
支持 -, |, &, ^(不同时包含于两个集合)
	difference() #返回新集合
    	difference_update() #在原集合上修改,无返回值 s1.difference_update(s2)
    union() #并集
    intersection() #交集
    	intersection_update() #返回交集
    isdisjoint() #判断两个集合是否包含相同的元素
    issubset() #判断指定参数的集合是否为该调用方法的集合的子集
    issuperset() #用于确定一个集合是否为另一个集合的超集, 它用于检查一个集合是否包含另一个集合的所有元素
    symmetric_difference() #返回两个集合中不重复的元素集合
    symmetric_difference_update() #移除相同的元素,并插入没有的元素

s.add(x) 添加元素
s.update(x) #可以添加多个元素,并且可以是列表元组字典
s.remove(x) #将元素从集合中移除, 如果不存在则报错
s.discard(x) #移除元素,但是不报错
s.pop() #设置随机删除结合中的一个元素(无序集合的第一个元素)
len(s) s.clear()
x in s
s.copy()
deque()
append()
appendleft()
extend()
extendleft()
pop()
popleft()
count()
insert(index, obj) #与list相同,在index位置插入obj, 本来在index上的元素往后移动
rotate(n) # 从右侧翻转n步(后n个元素放到前面),如果为负数,则从左边翻转
clear()
remove()
maxlen
	q = deque(maxlen = 2)
    #如果超过长度,则在另一侧删除
bisect
from bisect import *
idx = bisect(ls, x) # bisect 和 bisect_right等同
idx = bisect_left(ls, x) # 如果列表内没有此元素,那么返回合适的插入点索引
insort_left(ls, x)#插入元素并保持有序
insort(ls, x) # 等价于insort_right(ls, x)
import bisect
my_list = [1, 3, 5, 7, 9, 11, 13]
i = bisect.bisect_left(my_list, -1) #0
i = bisect.bisect_left(my_list, 8, lo=3, hi=6) #4
bisect.insort_right(my_list, 8, lo=3, hi=6) #[1, 3, 5, 7, 8, 9, 11, 13]
str
s = "hello world"
print(s.capitalize())  # Output: "Hello world"
print(s.upper())  # Output: "HELLO WORLD"
print(s.lower())  # Output: "hello world"
print(s.title())  # Output: "Hello World"
s = "Hello World"
print(s.swapcase())  # Output: "hELLO wORLD"
s = "  hello world  "
print(s.strip())  # Output: "hello world"
s = "hello world"
print(s.replace("world", "python"))  # Output: "hello python"
s = "hello world"
print(s.split())  # Output: ['hello', 'world']
words = ["hello", "world"]
separator = ", "
print(separator.join(words))  # Output: "hello, world"
s = "hello world"
print(s.startswith("hello"))  # Output: True
s = "hello world"
print(s.endswith("world"))  # Output: True
s = "hello world"
print(s.find("world"))  # Output: 6
s = "hello world"
print(s.count("l"))  # Output: 3
自定义比较参数
from functools import cmp_to_key

def compare(s1, s2):
    if len(s1) == len(s2):
        for c1, c2 in zip(s1, s2):
            if c1 > c2:
                return 1
            elif c1 < c2:
                return -1
        return 0
    else:
        if len(s1) > len(s2):
            return 1
        else:
            return -1

things = input().split()
# 使用 cmp_to_key 将比较函数转换为 key 函数
things.sort(key=cmp_to_key(compare))
print(things)
__init__魔术方法
class Fib(object):
    def __init__(self):
        pass
    def __call__(self, num): # 将对象作为函数调用时触发
        a, b = 0, 1
        self.l = []
        for i in range(num):
            self.l.append(a)
            a, b = b, a+b
        return self.l
    def __str__(self): # 使用print(对象)或者str (对象)的时候触发
        return str(self.l) # 必须返回字符串类型
    __rept__=__str__ # 使用repr(对象)

f = Fib()
print(f(10))
from itertools import combinations, permutations
from copy import deepcopy
from functools import lru_cache
from sys import stdin
from collections import defaultdict, deque, Counter
from heapq import *
import operator
from functools import cmp_to_key
ls = [1, 2, 3]
ls2 = [1, 2, 3]
print(operator.eq(ls, ls2))

for j in permutations(ls, 1):
    print(j)

for j in combinations(ls, 2):
    print(j)

len(ls)
max(ls)
min(ls)
list(s)
ls.append()
ls.count()
ls.index()
ls.extend()
ls.insert(index, obj)
ls.pop(index)
ls.remove()
ls.reverse()
ls.sort(key = lambda x:-x, reverse = True)
ls.clear()
ls.copy
print(s.capitalize())
print(s.capitalize())
print(s.capitalize())
print(s.lower())
print(s.upper())
print(s.title())